Comment diagnostiquer un goulot d’étranglement (bottleneck) sur une base de données MySQL / PostgreSQL
Pourquoi votre base de données rame-t-elle et comment y remédier ?
Dans toute architecture logicielle, la base de données est souvent le cœur battant de l’application… mais aussi son maillon le plus sensible. Un temps de réponse qui grimpe, des requêtes qui s’accumulent, un CPU à 100 % ou des entrées/sorties disque complètement saturées : les symptômes d’un goulot d’étranglement (bottleneck) peuvent paralyser l’intégralité de vos services et impacter directement l’expérience de vos utilisateurs.
Identifier l’origine exacte d’une baisse de performance s’apparente parfois à une enquête. Est-ce une requête mal optimisée qui scanne toute une table ? Un manque de mémoire vive qui force des écritures permanentes sur le disque ? Ou encore un verrou (lock) posé par une transaction trop longue qui bloque toutes les autres ?
Que vous utilisiez MySQL ou PostgreSQL, la méthode de diagnostic reste structurée. Ce guide vous détaille les étapes clés et les outils incontournables pour isoler le problème, analyser les métriques système et SQL, et restaurer la fluidité de votre base de données.
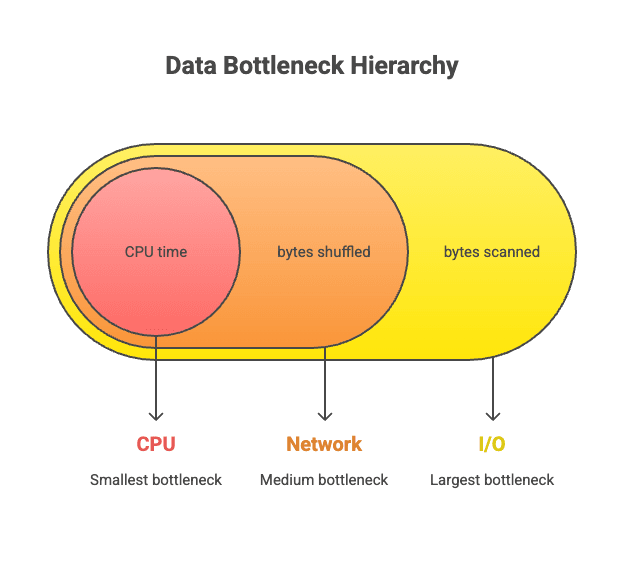
Un goulot d’étranglement sur une base de données ralentit l’ensemble de votre pile applicative. Pour diagnostiquer efficacement l’origine de la lenteur (disque, CPU, verrouillage), suivez cette méthodologie d’analyse.
Étape 1 : Analyser l’utilisation des ressources système
Avant de plonger dans le moteur SQL, utilisez des outils système pour identifier la ressource saturée :
-
htopoutop: Vérifiez si le processusmysqldoupostgress’accapare l’intégralité du CPU. -
iotopouiostat -xz 1: Surveillez la valeur%util(utilisation du disque) et le temps d’attente d’écriture (await). Un disque saturé est le bottleneck le plus fréquent en base de données.
Étape 2 : Traquer les requêtes lentes (Slow Queries)
Identifiez les requêtes SQL mal indexées qui lisent des millions de lignes inutilement.
-
Pour MySQL : Activez le Slow Query Log dans votre fichier
/etc/mysql/my.cnf:Ini, TOML
slow_query_log = 1
slow_query_log_file = /var/log/mysql/mysql-slow.log
long_query_time = 1.0 # Logge les requêtes de plus d'une seconde
log_queries_not_using_indexes = 1
Analysez ensuite ce fichier avec
mysqldumpslowou l’outil pt-query-digest (Percona Toolkit). -
Pour PostgreSQL : Utilisez l’extension incontournable
pg_stat_statements. Ajoutez ceci danspostgresql.conf:Ini, TOML
shared_preload_libraries = 'pg_stat_statements'Puis exécutez cette requête pour lister les requêtes les plus gourmandes en temps cumulé :
SQL
SELECT query, calls, total_exec_time, rows FROM pg_stat_statements ORDER BY total_exec_time DESC LIMIT 10;
Étape 3 : Diagnostiquer les verrous (Locks)
Deux requêtes concurrentes qui s’attendent mutuellement peuvent paralyser votre base.
-
MySQL : Visualisez l’état des verrous avec
SHOW ENGINE INNODB STATUS;ou examinez la tableinformation_schema.innodb_trx. -
PostgreSQL : Détectez les blocages actifs grâce à la table système
pg_locksjointe àpg_stat_activitypour repérer quelle transaction bloque les autres.
Conclusion / Étapes suivantes (Optionnel)
Une fois le problème localisé grâce à ce diagnostic, l’étape suivante consiste à appliquer le correctif adapté : ajouter un index pertinent, revoir la modélisation des tables, ajuster le paramétrage de la mémoire (innodb_buffer_pool_size sur MySQL ou shared_buffers sur PostgreSQL), ou encore optimiser le code applicatif pour réduire le temps de maintien des verrous.
Un serveur a administrer, une panne a traiter, un projet a heberger ?
Nous gerons des serveurs pour des entreprises depuis la Guadeloupe. Dites-nous ce dont vous avez besoin, nous repondons avec une proposition claire.
« Le client previent d'un passage TV au dernier moment et la team @demarcq se met en quatre pour dimensionner l'infrastructure avec nous. »Rene Cotton — message publie publiquement sur X
Lire les 12 temoignages clients, publies publiquement et verifiables →